Microsoft Decision-1 vs Jev: 같은 판단 API, 다른 선택 기준
예상 읽기시간: 8분 · 난이도: 중급 — API·분류·확률의 기초 개념을 다룹니다.
세 줄 요약
- 둘 다 ‘답장을 쓰는 AI’보다 ‘코드가 사용할 판단을 반환하는 AI’에 가깝습니다. 상태와 제한된 질문을 받아 선택·점수·확률을 반환합니다.[3][4]
- Decision-1은 Azure 운영 체계와 공개된 기반 모델이, Jev는 병렬 질문·명시적 confidence와 버전 선택이 주요 검토 지점입니다. 기반 모델 공개는 최종 가중치 공개와 다릅니다.[3][6][9]
- 공개 입력 단가는 둘 다 100만 토큰당 0.042달러이며 출력은 무료입니다. 어느 쪽이 더 정확하고 빠른지는 동일한 업무·버전·지역에서 따로 확인해야 합니다.[1][6][8]
확인 기준: 2026년 11월 3일(KST). Microsoft 발표일은 2026년 10월 9일입니다.[1] Jev의 초기 소개글과 최신 공식 문서를 구분했습니다. 소개글의 정확한 발행일은 이번 확인 자료에서 확정하지 않았습니다. 이 글은 공개 문서 비교이며, 유료 API 호출·자체 동일 조건 실험은 수행하지 않았습니다. 기업의 성능 설명은 독립 검증 결과와 구분합니다.
1. 경쟁하는 지점부터 맞추기
가상 고객 문의가 들어왔습니다. “요금이 두 번 나갔습니다. 확인하고 돌려주세요.” 필요한 작업은 둘로 나뉩니다. 누구에게 보낼지 판단하는 일과 실제로 환불해도 되는지 확인하고 실행하는 일입니다.
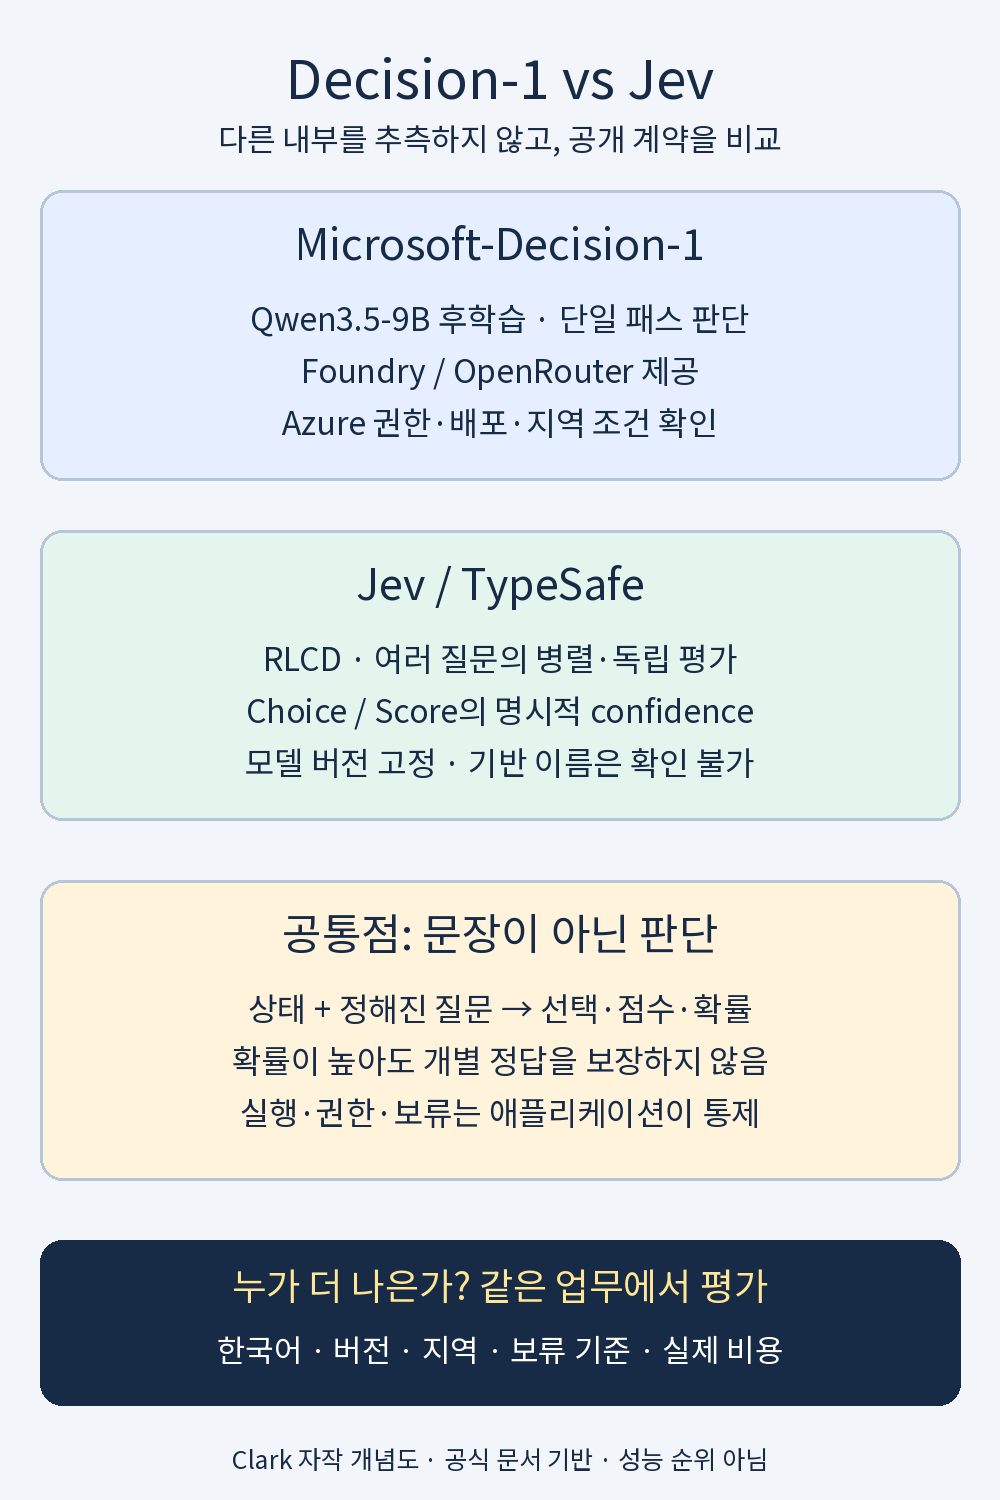
Decision-1과 Jev는 첫 번째 작업의 후보입니다.[3][11] 둘 다 자유문장을 길게 생성하는 대신, 미리 정의한 질문과 답의 범위 안에서 판단을 반환합니다.[3]
판단을 받은 뒤 권한·원장·정책을 확인하고 실행하는 책임은 애플리케이션에 남겨야 합니다. 이는 이 글의 설계 원칙이지 두 서비스를 실제 연결해 검증한 결과는 아닙니다.
2. 구조·학습: 공개한 내용의 범위가 다릅니다
| 비교 항목 | Microsoft-Decision-1 | Jev |
|---|---|---|
| 기반 모델 | Qwen3.5-9B를 Microsoft가 후학습했다고 명시합니다.[1][9] | 확인한 공식 소개·학습·모델 문서에는 기반 체크포인트명과 파라미터 수가 명시돼 있지 않습니다.[2][6][10] |
| 학습 접근 | 빠른 단일 패스 판단을 위한 후학습입니다. 공개 데이터와 팀이 만든 합성 데이터를 사용했다고 설명합니다.[1][9] | 새 아키텍처·병렬 샘플러와 RLCD(Reinforcement Learning for Calibrated Decisions)를 설명합니다.[2][10] |
| 공개 수준의 한계 | 소개·모델 카드만으로 학습 목적함수와 전체 학습 과정을 재현할 수는 없습니다.[1][9] | RLCD라는 명칭만으로 기반 모델 계보나 학습 전체를 재현할 수는 없습니다.[2][10] |
| 추론·출력 | 한 번의 모델 호출로 정해진 선택지의 확률을 산출하는 single-pass scoring입니다.[9] | 같은 상태에 대한 여러 질문을 병렬·독립적으로 평가한다고 설명합니다.[4][6] |
| 제공 경로 | Microsoft Foundry·OpenRouter의 호스팅 제공을 안내합니다.[1] | TypeSafe의 POST /v1/systemone API를 안내합니다.[6][11] |
‘기반 공개’와 ‘가중치 공개’를 분리해야 합니다. Qwen3.5-9B가 오픈웨이트라는 설명을 Decision-1 최종 체크포인트도 내려받아 자체 호스팅할 수 있다는 뜻으로 확장하면 안 됩니다.[9]
마찬가지로 Jev의 기반 이름을 확인하지 못했다고 “처음부터 전부 새로 학습한 모델”이라고 단정할 수도 없습니다. 공식 학습 문서가 제시하는 경로는 사전학습 모델에서 RLCD로 이어집니다.[10]
Jev의 학습 설명은 사전학습 언어 모델에서 RLCD로 이어지는 경로를 제시합니다.[10] 따라서 “LLM과 전혀 관계없는 존재”보다는 텍스트 생성 대신 판단을 위해 후학습·추론·인터페이스를 설계한 제품으로 이해하는 편이 안전합니다. 두 제품의 내부 구현이 같다고 주장하는 것도 아닙니다.
이 글의 Jev는 TypeSafe의 상용 모델입니다.[6] 이름이 비슷한 Kev 등 별도 재현 프로젝트의 기반 모델 정보를 Jev의 정보로 옮겨 적지 않았습니다. 외부 벤치마크도 Jev의 기반 모델을 undisclosed로 표기합니다.[8]
3. 출력·확률 보정: 같은 숫자처럼 보여도 의미를 확인해야 합니다
두 문서는 공통으로 세 종류의 질문을 안내합니다.[3][4]
| 질문 | Decision-1 문서 | Jev 문서 |
|---|---|---|
| 참인가 | noul: 0~1 확률입니다.[3] | noul: 0~1 값이며 별도 confidence는 없습니다.[4][7] |
| 무엇인가 | choice: 선택 결과와 선택지별 확률입니다.[3] | choice, probabilities, confidence입니다.[4] |
| 어느 정도인가 | score: 순서가 있는 단계와 단계별 확률을 다룹니다.[3] | score, probabilities, confidence입니다.[4] |
질문 이름이 비슷하다고 엔드포인트·인증·응답 필드까지 그대로 교환할 수 있다는 뜻은 아닙니다.[3][6]
Microsoft는 Foundry 리소스의 /providers/microsoft/v1/systemone 경로를, TypeSafe는 자체 API의 /v1/systemone 경로를 안내합니다.[3][6] 이 글에서는 SDK 호환성을 시험하지 않았습니다.
Jev의 confidence는 정답률을 따로 관측한 값이 아니라, 반환한 확률 분포에서 계산한 요약값입니다. Choice와 Score의 계산 방식도 다릅니다.[7]
예를 들어 공식 문서의 3지선다 분포 (0.6, 0.3, 0.1)은 Choice confidence가 0.4입니다.[7] 따라서 confidence 0.4를 곧바로 “정답일 확률 40%”로 읽으면 안 됩니다.[7]
확률 보정(calibration)은 비슷한 확률을 준 사례들을 모았을 때 실제 빈도와 얼마나 맞는지의 문제입니다.[10]
Jev 문서도 개별 답변의 정답을 보장하는 것이 아니라고 설명합니다.[11] Microsoft 역시 익숙한 유형에서 보정이 가장 강하며, 실제 라벨 데이터로 임계값을 검증하라고 안내합니다.[3]
TypeSafe가 말하는 “환각 0%”도 범위를 좁혀 읽어야 합니다.[5] 현재 홈페이지는 이를 정해진 스키마를 지키는 보장이지, 실험으로 관측한 내용상 오류율 0%가 아니다라고 설명합니다.[5]
틀린 부서를 골라도 허용된 부서명만 반환했다면 형식은 맞을 수 있습니다. 홈페이지 역시 이 차트가 모든 답의 정답성을 뜻하지 않는다고 명시합니다.[5]
4. 성능: 서로 다른 성적표를 한 경기처럼 읽지 않기
Microsoft의 자체 평가: 학습에서 블라인드 처리한 36개 벤치마크, 약 15만 문항에서 가장 높은 정확도를 기록했다고 발표했습니다.[1] 이는 Microsoft가 구성한 평가 결과입니다. 본문에는 Jev 정확도·보정 비교를 추가했다는 편집자 주석도 있지만, 이 발표를 모든 업무·최신 Jev 버전에 대한 우위로 일반화할 수는 없습니다.[1]
TypeSafe의 자체 평가: “193.6배 빠르고 444.6배 저렴하다”는 수치는 System One 워크플로 평가에서 나온 값이며, 업체 스스로 실제 개선폭의 상단에 가까울 수 있다고 설명합니다.[2] 참조 답은 강력한 외부 모델들의 평균 예측이고, LLM에는 확률을 포함한 구조화 출력을 위한 래퍼를 사용했습니다.[2] 이는 Decision-1과 직접 같은 조건으로 대결해 얻은 배수가 아닙니다.
외부 평가: TypeSafe와 독립적으로 비교한다고 밝힌 Benchmark Heaven의 JevBench API 표에는 다음과 같은 기존 ranked 행이 있습니다.[8]
| 해당 표의 제품·행 | Composite 점수 | 표시된 중앙 지연시간 |
|---|---|---|
| Jev 1.13.0 | 71.4 | 0.24초 |
| Jev 1.14.0 | 70.2 | 0.23초 |
| Microsoft-Decision-1 기존 행 | 69.1 | 0.48초 |
이 점수는 정확도 백분율이 아니라 지능·보정·속도·비용을 결합한 지표입니다.[8]
더 중요한 함정은 같은 페이지에 Decision-1의 A2 잠정 재평가 행과 업데이트 가중치 행이 따로 존재한다는 점입니다.[8]
업데이트 행에는 Composite 77.0이 표시되지만 unranked이며, 변경 이력은 10월 27일 추출 문제와 10월 28일 추가된 유료 평가, 기준 척도 연결 미완료를 명시합니다.[8]
따라서 기존 행만 보고 “Jev의 승리”, 업데이트 행을 기존 Jev 행과 직접 빼서 “Decision-1의 역전”이라고 결론 내리지 않습니다.[8] 표의 측정 시점·문제 추출·가중치·기준 척도가 다를 수 있고, 서비스 지연에는 네트워크와 제공 지역도 영향을 줍니다.[3][8] 외부 벤치마크는 후보를 좁히는 근거이지 우리 업무의 최종 판정은 아닙니다.
5. 가격·가용성: 단가는 같지만 운영 조건은 다릅니다
| 비교 항목 | Decision-1 | Jev |
|---|---|---|
| 공개 입력 단가 | 100만 토큰당 0.042달러입니다.[1] | 100만 토큰당 0.042달러입니다.[6] |
| 출력 요금 | 무료입니다.[1] | 무료입니다.[6] |
| 접근·운영 | Foundry 배포·Azure 권한과 인증, 또는 OpenRouter 제공 경로를 확인해야 합니다.[1][3] | 초기 소개는 early access를 안내합니다. 실제 접근 가능 여부와 조직별 한도는 별도 확인 대상입니다.[2][6] |
| 문맥 길이 | 모델 카드는 최대 32K 입력을 설명합니다.[9] | 기본 요청당 64k·질문당 32k입니다.[6] |
| 버전 관리 | 발표된 Qwen 기반과 향후 다른 기반으로의 변경 계획을 구분해야 합니다.[1] | jev-latest는 1.13.0, jev-preview는 1.14.0입니다. 최신 공개 버전 1.14는 10월 14일부터 제공됐다고 설명합니다.[6] |
Jev에는 별도 헤더로 요청·질문 한도를 모두 262k로 늘리는 기능도 있지만, 기본적으로 꺼져 있고 느려지며 정확도가 낮아진다고 문서가 경고합니다.[6]
컨텍스트 숫자가 크다는 이유만으로 긴 한국어 문서에서 더 낫다고 결론 내리면 안 됩니다.[6] 버전 별칭도 움직일 수 있으므로 비교 시에는 버전 ID를 고정하는 편이 좋습니다.[6]
가상 요금 계산: 각 서비스가 집계한 청구 입력이 각각 1억 토큰이라면, 발표 단가만 적용한 입력 요금은 각각 4.20달러입니다.[1][6] 실제 결제액을 측정한 결과는 아닙니다. 토큰 집계 방식·요청 구성·재시도·재평가·네트워크·운영 비용을 같다고 가정하지 않았습니다. 같은 토큰 단가와 같은 업무 총비용은 별개입니다.
6. 언제 무엇을 먼저 검토할까
다음은 문서상 기능과 운영 조건에 근거한 선택 가이드이며, 성능 우열이나 도입 성공을 보장하는 추천은 아닙니다.
- 이미 Azure에서 권한·배포·지역을 관리한다면 Decision-1을 먼저 검토할 수 있습니다. Foundry의 운영 경로와 데이터 존 배포 옵션을 함께 점검할 수 있기 때문입니다.[3] 모든 지역에서 같은 지연이나 가용성을 보장하는 것은 아닙니다.[3]
- 하나의 상태에 여러 독립 질문을 묶고, 확률 분포와 confidence를 코드로 조합하려면 Jev를 검토할 수 있습니다.[4] 질문을 작게 나누고 후속 로직을 코드로 두는 방식이 공식 문서의 중심 패턴입니다. 다른 모델에서 불가능하다는 뜻은 아닙니다.[4][7]
- 한국어 문의·내부 용어가 핵심이면 둘 다 실제 데이터 평가를 먼저 해야 합니다. Jev는 영어가 주 학습 언어이며 CJK 등 다른 언어의 정확도가 같지 않다고 명시합니다.[6] Microsoft의 다국어 자체 평가도 특정 한국어 업무의 보증은 아닙니다.[1]
- 답장·요약·코드·서술형 이유가 필요하면 둘 중 하나로 끝내려 하지 않는 편이 좋습니다. 두 제품은 생성형 설명을 출력하지 않으므로, 판단 계층과 생성형 모델을 분리하는 설계를 검토할 수 있습니다.[3][11]
- 완전한 자체 호스팅이 필수라면 공개 기반 모델 이름만으로 결정하지 않아야 합니다. 최종 가중치·배포 라이선스·운영 지원의 확보 여부를 별도로 확인해야 합니다.
가상 환불 문의라면 두 후보에 같은 한국어 상태·선택지·보류 옵션을 주고, 명확한 요청뿐 아니라 정보 누락·부정 표현·오래된 정책도 함께 평가하는 방법을 제안합니다. 모델이 환불 의도를 잘 읽어도 실제 중복 청구 여부는 원장으로 확인하고, 환불 권한은 별도 코드와 승인 체계가 통제해야 합니다. Jev의 공식 환불 워크플로 예시도 판단과 결정적 코드 검사를 조합하는 방식을 안내합니다.[11]
비교 결과에는 정확도만 남기지 않는 편이 좋습니다. 버전·입력/질문 구성·보류율·오탐과 미탐·확률 보정·p50/p95 지연·재시도 포함 비용·데이터 처리 조건을 함께 기록해야, 빠르지만 더 자주 틀리는 후보와 느리지만 자동 처리 범위가 넓은 후보를 구별할 수 있습니다. 이는 향후 실험을 위한 제안이며 이 글에서 실행한 시험이 아닙니다.
결론: 지금 고를 것은 승자보다 평가의 출발점입니다
Decision-1은 공개된 Qwen 기반과 Foundry 운영 경로를, Jev는 RLCD·병렬 질문·명시적 confidence와 버전 선택을 확인할 수 있는 판단 API입니다.[1][4][6]
공통점은 문장 생성 대신 제한된 판단을 소프트웨어에 넘긴다는 데 있습니다.[3][11]
어느 모델을 택하든 타입 안전성 ≠ 내용의 정답성 ≠ 실행 권한입니다.[5][9] 같은 단가나 벤치마크 한 줄로 결론 내리기보다, 실제 업무에서 틀렸을 때의 비용과 보류 기준을 고정한 뒤 비교하는 편이 안전합니다.
확인 한계
공식 소개·문서·모델 카드와 외부 평가를 읽었지만 자체 API 호출·같은 지역의 부하 시험·한국어 정답셋 실험·내부 학습 코드 검증은 하지 않았습니다. Jev 기반 모델 미공개 판단은 이번에 확인한 공식 자료의 범위로 한정합니다. 가격·별칭·지원 지역은 확인 뒤 바뀔 수 있으며 계약·실제 계정 접근 가능 여부는 검증하지 않았습니다. 이미지 라이선스 페이지는 웹 추출로 확인했으며 직접 HTTP 요청은 403으로 제한됐습니다.
이전 글: Microsoft Decision-1 소개 · Jev 구조와 LLM 비교 · Jev 공개 성능 근거
Sources
[1] Microsoft · Introducing Microsoft-Decision-1, our model for fast decision-making
[2] TypeSafe AI · Introducing System One Models & Jev
[3] Microsoft Learn · Deploy and use Microsoft-Decision-1 in Microsoft Foundry
[8] Benchmark Heaven · JevBench API leaderboard: hosted decision APIs
[9] Microsoft Foundry · Microsoft-Decision-1
[10] TypeSafe · AI primer
[12] Wikimedia Commons · Joseph Ducreux, Self-Portrait in a Mocking Pose — photograph by Sailko
